In-the-Loop-Verfahren sind in Branchen mit großen Budgets und Nachweispflicht Standard. Außerhalb davon lohnt sich nicht jede Stufe. Dieser Beitrag schlüsselt den Nutzen, Kosten, Chancen und Risiken der Testphasen auf, damit Sie bewerten können, ob es sich für Ihre Embedded Software Entwicklung lohnt.
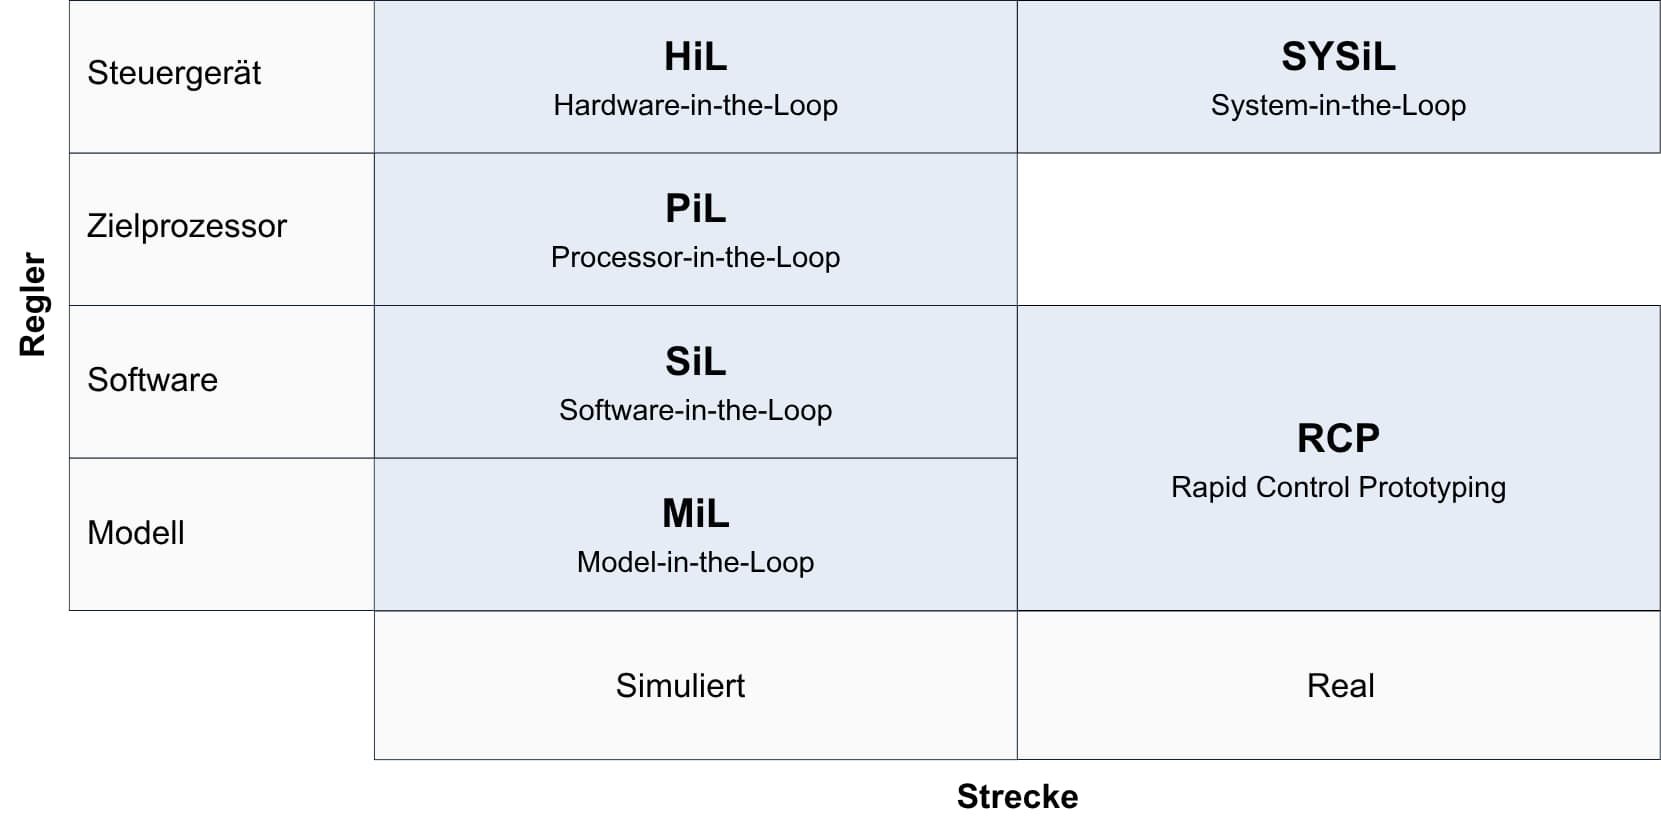
Abbildung 1: Einordnung der Verfahren nach Realisierung von Regler und Strecke. Im System-in-the-Loop arbeitet erstmals das Seriensteuergerät an der realen Strecke; welche internen Größen dort beobachtbar sind, hängt vom verfügbaren Zugang ab (Quelle: eigene Abbildung).
Bei der Entwicklung von Motorsteuerungen, Batteriemanagementsystemen (BMS) oder Umrichtern muss entschieden werden, welche Prüfstufen (Abbildung 1) eingesetzt werden, um die Fehlersuche nicht erst dort zu beginnen, wo sie am teuersten ist. Eine Stufe, die Vorhandenes weiterverwendet, etwa ein Modell, eine Testsuite oder die reale Strecke, ist weniger aufwendig. Sie rechnet sich als Investition, wenn sie eine Lücke der vorigen Stufe schließt, dieselbe Prüfung oft wiederholt wird oder sie Fehler früh abfängt, die am realen System teuer oder gefährlich wären. Oft bringt jedoch nicht die nächste Stufe den größten Nutzen, sondern ein besserer Einblick in eine vorhandene Stufe, vor allem beim Test am realen System (SYSiL). Dort lassen sich interne Größen mit wenig Aufwand sichtbar machen und die Fehlersuche wird verkürzt.
Ein Batteriemanagementsystem, eine Motorsteuerung, ein aktiver Filter: Alle drei laufen als Firmware auf einem eingebetteten System und schließen eine Regelschleife mit realer Hardware. Bevor diese Hardware zum ersten Mal Strom führt, muss klar sein, dass die Software richtig arbeitet. Wie viel Prüfung davor sinnvoll ist, entscheidet, ob ein Fehler einen Simulationslauf kostet oder eine Endstufe.
Die Antworten reichen von printf auf dem realen System, also Zwischenwerten über die serielle Schnittstelle, bis zur HiL-Station mit Leistungsverstärker und Echtzeitrechner. Viele etablierte Verfahren stammen aus der Luftfahrt und sind heute Standard im Automobilbau, in der Verteidigung, im Schiffbau und in der Raumfahrt: Branchen mit großen Budgets, hohen Stückzahlen oder strengen Nachweispflichten. Ein Team, das einen Umrichter in kleiner Serie entwickelt, hat meist weder das Budget noch die Stückzahl dafür.
Modellbasierte Entwicklung und Testen eingebetteter Software
In der modellbasierten Entwicklung (Model-Based Design, MBD) wandern Regler und Strecke schrittweise vom Modell in die Wirklichkeit (Abbildung 1) [Garousi et al. 2018]. Jede Stufe hat ihr eigenes Prüfverfahren, zusammen X-in-the-Loop (XiL) genannt (Abbildung 1 und 2). Bei Model-, Software- und Processor-in-the-Loop bleibt die Strecke simuliert. Bei Hardware-in-the-Loop läuft das reale Steuergerät gegen eine Streckensimulation. Beim Rapid Control Prototyping ist es umgekehrt: Ein Echtzeitrechner regelt die reale Strecke und bleibt dabei vollständig zugänglich. Bei System-in-the-Loop schließlich ist alles real.
Mit jeder Stufe wächst der Realitätsgrad, dabei verändern sich auch die Möglichkeiten zur Beobachtung der Software. Auf dem Zielsystem kostet sie Rechenzeit, Speicher, Busbandbreite oder zusätzliche Hardware, und ein Versuch an der realen Strecke lässt sich nicht identisch wiederholen. Schon ein Hardware-in-the-Loop-Simulator sieht selbst nur die Ausgänge des Prüflings [Mihalič et al. 2022]. Die Stufen sind keine Pflichtfolge. Ihr Hauptzweck ist, mit dem Prüfen nicht zu warten, bis die Hardware fertig ist. Sie lohnen sich deshalb vor allem, wenn Hardware und Software parallel entstehen. Steht die Hardware schon, bleiben zwei Gründe: Versuche, die an der realen Strecke zu gefährlich oder zu teuer wären, und Prüfungen, die sich oft genug wiederholen, um sie zu automatisieren. Geprüft wird jedes System spätestens an der realen Strecke.
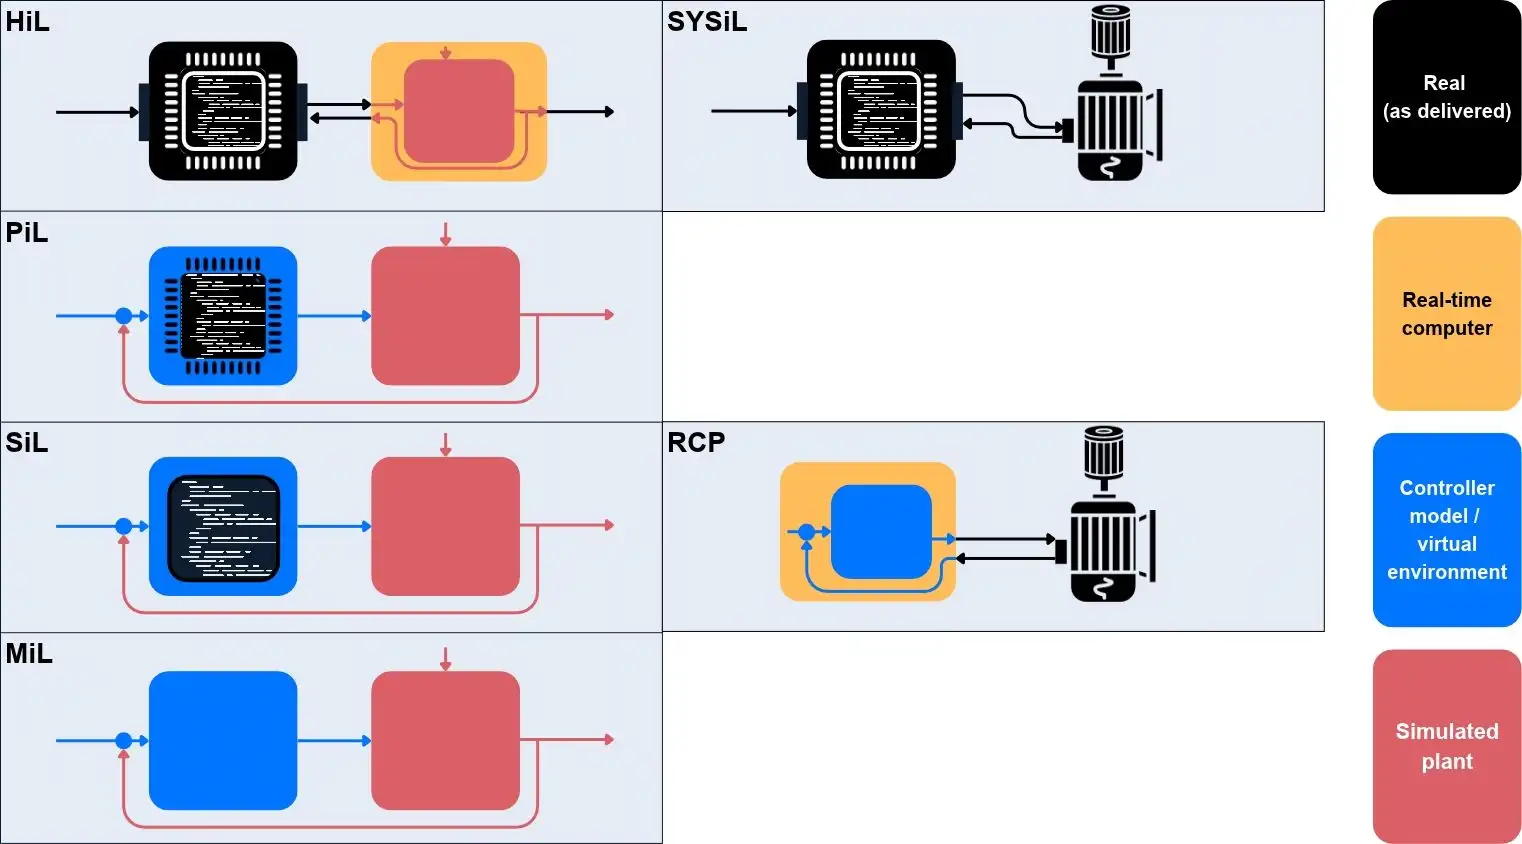
Abbildung 2: Einordnung der Verfahren, mit Kennzeichnung des realen Anteils (schwarz), des Echtzeitcomputers (gelb), des Steuerungsmodells in der virtuellen Umgebung (blau) und der simulierten Regelstrecke (rot) (Quelle: eigene Abbildung).
System und Umgebung liegen als Modell vor und werden gemeinsam simuliert. Die Modellierung ist Ingenieursarbeit und keineswegs billig. Billig ist die Iteration: Eine Änderung kostet einen Simulationslauf, kein Kompilieren, kein Programmieren, keinen Prüfaufbau. MiL ist in industriellen Projekten weit verbreitet. Die Lücke beginnt danach: zwischen dem simulierten Regler und dem Code auf dem realen System.
Lohnt sich, wenn eine Regelung oder ein zustandsbehafteter Automat abzusichern ist, bevor die Hardware existiert, oder wenn Experimente an der Hardware gefährlich wären.
Nutzen. Nur hier lässt sich der Regler analytisch auslegen statt nur prüfen: Linearisierung, Frequenzgänge, Stabilitätsreserven, Parametersweeps über hunderte Konfigurationen. Grenz- und Fehlerfälle lassen sich durchspielen, bevor Hardware existiert.
Kosten. Den größten Posten bilden die Ingenieurstunden für Modellierung, Parametrierung und Simulation. Hinzu kommen Werkzeuglizenzen (Simulink, kommerzielle Modelica-Umgebungen). In der Praxis übersteigen Personalkosten die Lizenzkosten schnell.
Chance. Die Artefakte werden weitergereicht statt verbraucht. Aus dem Reglermodell kann per Codegenerierung Software entstehen, aus dem Modellverhalten können Testfälle für alle folgenden Stufen entstehen. Das Streckenmodell kann später auf dem HiL-Prüfstand laufen, wenn es echtzeitfähig strukturiert ist: feste Schrittweite, garantierte Rechenzeit je Schritt. Wer das von Beginn an berücksichtigt, bezahlt hier schon einen Teil des HiL-Aufwands.
Risiko. Die Abweichung zwischen Modell und Realität ist unvermeidlich. Gefährlich ist die unbemerkte Abweichung, denn geprüft wird der Regler gegen das Modell, nicht das Modell gegen die Wirklichkeit. Auch was erst die Implementierung mitbringt, also Festkomma, Rechenzeit und Ablaufverhalten, kann MiL grundsätzlich nicht abbilden. Plausibilisierung und Sensitivitätsanalysen begrenzen das. An Hardware identifizierte Parameter gelten nur im vermessenen Betriebsbereich. Das Gegenrisiko ist Über-Modellierung: Modelltreue, die keine Entwurfsentscheidung mehr beeinflusst, ist versenkter Aufwand.
Code wird von Hand geschrieben oder aus einem Modell generiert. Dieser Code läuft kompiliert auf dem PC, noch ohne Zielhardware, und regelt dort das Streckenmodell. Zwei Fragen stehen im Raum: Verhält sich der Code wie das Modell? Und arbeiten Regelung, Zustandslogik und Kommunikationsschichten zusammen? Wer von Hand programmiert und auf dem PC testet, hat einen Teil davon schon: Unit-Tests prüfen Funktionen einzeln gegen erwartete Werte. Was sie nicht prüfen, ist das Verhalten im geschlossenen Kreis mit der Strecke. Die stärkste Form hat SiL mit dem Modell aus MiL als Referenz.
Lohnt sich, wenn ein Streckenmodell bereitsteht und sich der Code oft genug ändert, dass eine automatische Regression ihren Pflegeaufwand einspielt. Dafür reicht oft schon ein einfaches Streckenmodell.
Nutzen. Da der Code auf dem PC läuft, lässt er sich jederzeit anhalten, untersuchen und ändern, und die Codeüberdeckung zeigt, welche Zweige noch kein Test erreicht hat. Belastbar ist das allerdings nur für die Testvektoren, die tatsächlich gefahren wurden.
Kosten. Bei den Werkzeugen reicht die Spanne von teuer bis kostenlos. Kommerzielle Ketten bringen ein virtuelles Steuergerät, Restbussimulation und anerkannte Überdeckungsmessung mit. In AUTOSAR-Projekten simulieren sie zudem Basissoftware und Kommunikationsstack, was sich mit freien Werkzeugen kaum nachbauen lässt. Ohne solche Anforderungen genügen ein Testrahmen, gcov und ein CI-Server. Der eigentliche Aufwand liegt woanders:
Chance. Weil SiL weder Board noch Echtzeit braucht, kann es bei jeder Codeänderung automatisch laufen, und ein Fehler fällt zeitnah auf. Ein Teil der Testvektoren lässt sich später in PiL und HiL wiederverwenden. Bei geschalteter Leistungselektronik stößt das an eine Grenze: Ein Umrichtermodell mit Schrittweiten unter einer Mikrosekunde rechnet auf dem PC langsamer als in Wirklichkeit, ein Testlauf dauert dann länger als der Vorgang, den er nachbildet. Gemittelte Modelle halten den Lauf kurz, zeigen dann aber keine Schaltvorgänge mehr.
Risiko. Am gefährlichsten ist es, Toleranzen so weit aufzuweiten, dass der Vergleich mit dem Modell oder den Erwartungswerten immer besteht. Der Testrahmen muss den Code im selben Takt aufrufen wie das Zielsystem, sonst ist der Vergleich hinfällig. Interrupts, Nebenläufigkeit und Latenzen bildet die Hardwareabstraktion meist gar nicht ab. Wurde die Strecke für den PC nachgebaut, prüft die Testsuite zudem womöglich gegen eine Kopie, die vom Modell abweicht. Eine hohe Codeüberdeckung schließlich belegt nur, dass der Code ausgeführt wurde. Über seine Richtigkeit sagt sie nichts.
Ist die Strecke schon real, der Regler aber noch ein Prototyp, lässt er sich mit RCP am realen Motor, Prüfstand oder Fahrzeug erproben. Schäuffele und Zurawka unterscheiden zwei Arten, je nachdem, ob schon ein Steuergerät existiert (2010, Abschn. 5.3.8.3):
Lohnt sich, wenn die Strecke vor dem Steuergerät da ist oder das Streckenmodell zu unsicher ist, um den Regler allein am Modell abzustimmen. Der Bypass lohnt sich, wenn ein Seriensteuergerät existiert und nur eine Funktion neu ist. Wer dagegen schon Zielhardware hat, die schnell genug ist, kann den letzten Schritt gehen: abstimmen und beobachten auf dem Zielsystem selbst. Dann ist das Experimentiersystem das Zielsystem, und die Übertragungslücke verschwindet.
Nutzen. Hier trifft der Regler zum ersten Mal auf die Wirklichkeit. Reibung, Sättigung, Sensorrauschen und Totzeiten stammen jetzt aus der realen Strecke. Der Regler selbst bleibt dabei ein Modell, das sich in Minuten ändern, neu kompilieren und laden lässt und dessen Signale alle beobachtbar sind. Läuft er auf einem Echtzeitrechner, also im Fullpass oder externen Bypass, steht zudem reichlich Rechenleistung zur Verfügung, und der Entwickler kann sich ganz auf die Regelung konzentrieren.
Kosten. Ein Echtzeitrechner mit passender Ein- und Ausgabe ist ein erheblicher Posten. Beim Fullpass kommt die ganze Anbindung an die Strecke hinzu, bei einem Antrieb also PWM, Geber, Strommessung und Schutzabschaltung. Vieles davon kann das Steuergerät später ohnehin, für den Prototyp baut man es ein zweites Mal. Der Bypass spart diese Arbeit, braucht aber Hooks in der Steuergerätesoftware. Werkzeuge dafür gibt es nur für unterstützte Steuergeräte, und weil die Hooks in der jeweiligen HEX-Datei stecken, müssen sie mit jeder neuen Softwareversion neu gesetzt werden. Der interne Bypass braucht zudem freien Speicher und Rechenzeit im Steuergerät.
Risiko. Der Prototyp funktioniert, die Serie nicht. Auf dem Echtzeitrechner rechnet der Regler mit Gleitkomma, reichlich Rechenzeit und eigener Abtastrate. Auf dem Zielprozessor fehlt das oft, und die Lücke zeigt sich erst bei der Übertragung. Der externe Bypass verschärft das: Die Übertragung zum Prototyping-System und zurück kostet Zeit. Anders als in allen Stufen davor steht jetzt echte Hardware im Kreis. Ein Vorzeichenfehler, der in MiL einen Simulationslauf gekostet hätte, kostet hier eine Endstufe. Der Prototyp braucht deshalb eine Schutzabschaltung, die nicht von ihm selbst abhängt.
Chance. Bei MiL war die unbemerkte Abweichung des Modells von der Wirklichkeit das größte Risiko. RCP macht sie sichtbar, denn hier läuft der Regler an der echten Strecke und liefert Messdaten von ihr. Mit diesen Daten lassen sich die Parameter des Streckenmodells nachschärfen, und davon profitieren alle Stufen, die mit dem Modell arbeiten: MiL und SiL rechnen genauer, der HiL prüft gegen eine realistischere Strecke. Das setzt voraus, dass Modell und Messung dieselbe Sprache sprechen: gleiche Signalnamen, gleiche Parameter, eine gemeinsame Datenbasis.
Der Code zieht auf den Zielprozessor um, die Strecke bleibt auf dem PC. Kompiliert wird mit dem Zielcompiler, gerechnet auf dem Zielprozessor, etwa auf einem Evaluierungsboard, oder in einem Simulator (z. B. QEMU). Ein Simulator des Befehlssatzes erspart das Board, kennt aber meist die Eigenheiten des konkreten Mikrocontrollers nicht: Timer, ADC, PWM oder das Interruptverhalten. Hardwarenaher Code braucht dort Platzhalter. Nach jedem Abtastschritt tauschen PC und Prozessor ihre Werte über die Debug- oder eine serielle Schnittstelle aus. Die Kopplung läuft dabei nicht in Echtzeit. Echt ist nur die Rechenzeit jedes einzelnen Schritts: Sie lässt sich auf einem echten Prozessor messen, am besten über Zyklenzähler oder Trace-Schnittstelle, die bei passendem Prozessor auch die Codeüberdeckung auf dem Ziel liefert. Viele Teams lassen ihren Code parallel zur Hardwareentwicklung auf einem Evaluierungsboard laufen. Ob das schon PiL ist, wird unterschiedlich gesehen: Manche Werkzeuge verstehen darunter Testvektoren auf dem Ziel, andere den geschlossenen Kreis mit einem Streckenmodell auf dem PC. Hier ist das Zweite gemeint, denn nur so wird das Verhalten der Regelung auf dem Ziel prüfbar.
Lohnt sich, wenn schon eine SiL-Suite existiert, denn dann laufen dieselben Testvektoren mit wenig Mehraufwand auch auf dem Ziel. Das zählt vor allem bei ungewöhnlichen Architekturen wie 16-Bit-DSPs, bei Regelungen in Gleitkomma, deren Verhalten von der FPU des Ziels abhängt, und wo Nachweise gefordert sind. Wer ohne Modell und SiL-Suite arbeitet, kommt mit Unit-Tests auf dem Board und strenger statischer Analyse weit. Sie finden etwa nicht ausgerichtete Speicherzugriffe, die auf dem PC laufen und auf einem Cortex-M0 abstürzen.
Nutzen. Der Vergleich mit SiL zeigt, was die Plattform am Ergebnis ändert. Die FPU des Ziels rechnet anders als der PC, etwa bei FMA und Flush-to-Zero. Ein anderer Compiler legt Bitfelder anders aus und nutzt undefiniertes Verhalten anders aus. Auch die Breite von long, size_t und Pointern unterscheidet sich zwischen 64-Bit-PC und 32-Bit-Ziel. Aussagekräftig ist der Vergleich allerdings nur, wenn SiL schon mit denselben Datentypen rechnet wie das Ziel. Dazu liefert PiL Laufzeit und Speicherbedarf auf dem echten Prozessor, allerdings nur für die gefahrenen Pfade. Eine verlässliche Obergrenze für den Stack gibt erst eine statische Stackanalyse.
Kosten. Compiler und Debug-Probe sind normalerweise im Labor verfügbar. Die Arbeit steckt im Automatisieren von Flashen, Testlauf und Zurücklesen der Ergebnisse, und in der Wartezeit: Jeder Abtastschritt wartet auf den Austausch mit dem PC, deshalb läuft PiL deutlich langsamer als SiL. Sinnvoll ist daher, nur eine Auswahl der SiL-Tests auf dem Ziel nachzufahren. Wer alle fährt, baut eine Pipeline, die Stunden braucht und bald abgeschaltet wird. Echte Boards in einer CI brauchen außerdem Betreuung, weil sie sich aufhängen und neu gestartet werden müssen. Ein Simulator wie QEMU erspart das, liefert dafür aber keine echten Laufzeiten.
Chance. PiL findet Plattformfehler zu einem Zeitpunkt, an dem die Ursache noch leicht einzugrenzen ist: Code und Testvektoren sind dieselben wie in SiL, nur der Prozessor ist neu. Taucht dieselbe Abweichung erst im HiL auf, kommen auch Verkabelung, Streckenmodell und Zeitverhalten als Ursache in Frage, und die Suche dauert entsprechend länger.
Risiko. PiL prüft vor allem den Algorithmus auf dem neuen Prozessor. Wie lange ein Schritt rechnet, ist messbar, was zwischen den Schritten passiert, aber nicht. Weil der Code nach jedem Schritt auf den PC wartet, entsteht kein echter Ablauf: ISRs werden nicht zu den Zeitpunkten ausgelöst wie im Betrieb, und DMA und Präemption konkurrieren nicht um Bus und Rechenzeit. Race Conditions zwischen ISR und Hauptschleife, Jitter in der Abtastung und Latenzen zwischen Messung und Stellgröße kann PiL deshalb nicht ausschließen: Dass sie im schrittweisen Aufbau nicht auftreten, heißt nicht, dass es sie nicht gibt. Gerade dort entstehen aber die teuren Fehler eingebetteter Systeme. Auch die Kopplung selbst verändert das System, je nach Weg unterschiedlich. Hält ein Debugger den Kern an, laufen manche Timer weiter und andere bleiben stehen, je nachdem, wie die Peripherie für den Debug-Halt eingestellt ist. Wartet der Code dagegen auf neue Werte über eine Kommunikationsschnittstelle, läuft der Prozessor weiter: Timer zählen, Interrupts kommen, und für zeitabhängige Logik vergeht zwischen zwei Schritten viel mehr Zeit als im Betrieb. Den Watchdog muss man in beiden Fällen abschalten oder bedienen.
Jetzt steht das echte Steuergerät im Kreis, mit seiner eigenen Elektronik, seinen Ein- und Ausgängen. Ein Prüfstand spielt die Umgebung und schließt das Steuergerät dort an, wo es auch im Produkt angeschlossen wird: an analogen und digitalen Ein- und Ausgängen und an den Bussen. Das Steuergerät lässt sich nicht anhalten, also muss die Umgebung in Echtzeit mitrechnen. Damit ergibt sich das Zeitverhalten zum ersten Mal nicht aus Annahmen, sondern aus dem System selbst: Latenzen, Buslast, Interrupts. Die Strecke bleibt aber ein Modell. Beim Signal-HiL fließt keine nennenswerte Leistung. Der Prüfstand erzeugt Sensorsignale als Spannung, Widerstand, Frequenz oder PWM und schließt die Ausgänge mit Lastnachbildungen ab. Im geschlossenen Kreis (Closed Loop) reagiert ein Streckenmodell auf das Steuergerät. Nur so lassen sich Regelgüte und Stabilität beurteilen. Im offenen Kreis (Open Loop) spielt der Stand vorgegebene Signale und Busbotschaften ein, und die Reaktion wirkt nicht zurück. Geprüft werden dann Signalverarbeitung, Logik, Diagnose und Kommunikation. Fehlende Busteilnehmer ersetzt in beiden Fällen die Restbussimulation.
Ein Hinweis zum Begriff: In der Embedded-Softwareentwicklung heißt oft schon jeder automatisierte Test auf dem Board „HiL-Test“. Hier ist die Einbindung in eine echtzeitfähige Nachbildung der Umgebung gemeint.
Lohnt sich, wenn dieselbe Prüfung oft genug wiederkehrt. Der Aufwand für Aufbau und Pflege des Stands in Stunden, geteilt durch die Stunden, die jeder Durchlauf gegenüber der Prüfung von Hand spart, ergibt die Zahl der Durchläufe, ab der sich der Stand trägt. Die Rechnung kann jeder mit den eigenen Zahlen führen. Den Ausschlag gibt die Wiederholung, nicht die Komplexität des Systems.
Nutzen. Grenz- und Fehlerfälle lassen sich wiederholbar, automatisch und gefahrlos durchspielen, etwa indem der Stand Leitungen auf Masse oder Versorgung legt oder unterbricht. Wie fein die Aussage über das Zeitverhalten dabei ausfällt, bestimmen Schrittweite, Abtastung der Ein- und Ausgänge und Latenz des Prüfstands. Als Faustregel sollte die Schrittweite etwa zehnmal kleiner sein als der schnellste Vorgang, den der Test auflösen soll. Prozessorbasierte Stände rechnen mit Schrittweiten von einer Millisekunde bis zu einigen zehn Mikrosekunden. Für gemittelte Modelle reicht das, auch bei einer schnellen Stromregelung. Wer die Schaltvorgänge selbst sehen möchte, braucht Schrittweiten um eine Mikrosekunde und darunter. Üblich ist dafür ein FPGA, das bei Taktzeiten von wenigen Nanosekunden Schrittweiten bis unter eine Mikrosekunde erreicht (Lauss et al. 2016; Mihalič et al. 2022).
Kosten. Die Kosten hängen vor allem davon ab, ob der Stand im offenen oder im geschlossenen Kreis arbeitet. Für Diagnose und Kommunikation im offenen Kreis genügen oft Messtechnik, Relaiskarten zur Fehlereinspeisung, ein Busadapter und ein Ablaufskript. Ein Stand im geschlossenen Kreis braucht dagegen ein Echtzeitsystem mit passender Ein- und Ausgabe und ein echtzeitfähiges Streckenmodell, das meist den größten Posten ausmacht. Wurde das Modell schon in MiL mit fester Schrittweite aufgebaut, ist ein Teil dieser Arbeit bereits erledigt, andernfalls fällt sie jetzt an, oft unter Termindruck. Hinzu kommt in beiden Fällen der Rüstaufwand: Jeder Prüfling und jede Variante braucht einen eigenen Kabelbaum, eine eigene Konfiguration und angepasste Testabläufe.
Chance. Ein automatisierter Stand prüft nachts, ohne dass jemand danebensteht. Je öfter er läuft, desto mehr Prüfungen bekommt das Team für denselben Ingenieuraufwand. Was dafür entsteht, also Testabläufe, Restbussimulation und Fehlerbilder, lässt sich später in Abnahme und Fertigungsprüfung wiederverwenden. Den Stand selbst übernimmt die Fertigung dagegen selten, weil sie Taktzeiten von Sekunden verlangt. Damit sich das auszahlt, muss er von Anfang an so gebaut sein, dass sich Prüflinge und Varianten ohne großen Umbau wechseln lassen.
Risiko. Der Rüstaufwand je Variante kann die Ersparnis aufzehren. Das Streckenmodell altert, während sich das Produkt weiterentwickelt, und prüft dann in beide Richtungen falsch: Fehler rutschen durch, und korrektes Verhalten fällt durch. Die Ein- und Ausgabekette des Stands hat eigene Totzeiten, die leicht als Verhalten des Prüflings gedeutet werden. Der Prüfstand sieht zudem nur die Anschlüsse des Steuergeräts. Schlägt ein Test fehl, bleibt ohne Messzugang auf interne Größen, etwa über XCP oder es:prot, offen, was im Inneren passiert ist. Ein bestandener Test belegt nur die gefahrenen Szenarien und schließt Timing-Fehler außerhalb davon oder unterhalb der Schrittweite nicht aus. Häufen sich solche Unklarheiten, verlieren die Ingenieure das Vertrauen in den Stand und umgehen ihn.
Beim Signal-HiL bleibt die Leistungselektronik des Prüflings außen vor: Der Stand liest die Ansteuersignale und emuliert die Sensoren, Leistung fließt keine. Beim Power-HiL arbeitet der Prüfling dagegen mit seiner Leistungsstufe unter realen elektrischen Bedingungen. Ein Leistungsverstärker setzt die berechneten Größen in Ströme und Spannungen um, während die Gegenseite simuliert bleibt: Batterie, Maschine oder Netz. Meist hängt nur der leistungsführende Teil an der Leistungsstufe, Sensoren und Kommunikation laufen wie beim Signal-HiL auf Signalebene. Typisch ist ein Umrichter an einem Maschinenemulator, der das Klemmenverhalten der Maschine nachbildet. Dafür muss der Emulator Leistung in beide Richtungen führen, also motorisch wie generatorisch arbeiten (Vier-Quadranten-Betrieb). Ein Batterieemulator kommt mit zwei Quadranten aus.
Lohnt sich, wenn die Leistungsstufe des Prüflings mitgeprüft werden muss, sonst genügt ein Signal-HiL. Das betrifft vor allem Umrichter, Antriebe und Batteriesysteme, besonders wenn mehrere Lastvarianten zu prüfen sind oder die reale Last noch nicht verfügbar, zu teuer oder nicht gefahrlos zu betreiben ist. Wer nur eine Maschine einer Leistungsklasse antreibt, kommt mit einem klassischen Lastprüfstand aus zwei gekoppelten Maschinen meist günstiger weg.
Kosten. Die Anschaffung liegt nach unserer Erfahrung je nach Leistung und Bandbreite im mittleren fünf- bis sechsstelligen Bereich. Dazu kommen Anschlussleistung, Kühlung, Stellfläche und ein Sicherheitskonzept mit Not-Aus und Berührschutz, das oberhalb von 60 V Gleichspannung deutlich aufwendiger wird. Die Energie, die der Emulator aufnimmt, braucht außerdem einen Weg: einen gemeinsamen Zwischenkreis mit dem Prüfling, einen Bremswiderstand oder eine Rückspeisung ins Netz, die eigene Anforderungen an Netzrückwirkungen mitbringt. Bei gleicher Leistung entscheidet die Bandbreite über die Preisklasse: Ein träger Batterieemulator kostet weniger als ein Maschinenemulator, der Umrichter-PWM verkraften muss. Ein großer Teil des Aufwands steckt zudem im Wissen um Schrittweite, Koppelinduktivität sowie Gleichtakt- und Erdschleifenstörungen. Für viele mittelständische Teams ist es deshalb realistischer, einen Stand projektweise bei Prüflaboren, Instituten oder Dienstleistern zu mieten.
Nutzen. Der Prüfling arbeitet mit seiner eigenen Leistungsstufe unter echten Strömen und Spannungen. Damit wird prüfbar, was der Signal-HiL nicht zeigt: Ansteuerung und Totzeiten der Endstufe, Strommessung unter echten Schaltflanken, Erwärmung und das Ansprechen der eigenen Schutzfunktionen. Lastwechsel lassen sich so schnell fahren, wie der Emulator folgen kann, und mit einem Netzemulator auch Netzstörungen. Fehlerfälle wie ein Kurzschluss in der Maschine lassen sich kontrolliert nachstellen, ohne dass eine reale Maschine Schaden nimmt.
Chance. Die Chance liegt in der Rekonfigurierbarkeit. Ein Parametersatz macht aus derselben Plattform eine andere Maschine, ein anderes Batteriepack, ein anderes Netz, auf kleiner Fläche und ohne rotierende Teile. Jede Lastvariante, die nicht mehr physisch aufgebaut werden muss, zahlt auf die Amortisation ein.
Risiko. Die Kopplung zwischen Prüfling und Emulator ist selbst ein dynamisches Element: Totzeit, Tiefpassverhalten des Verstärkers und Messrauschen liegen im geschlossenen Kreis (Lauss et al. 2016). Filter beruhigen den Kreis, verfälschen aber das nachgebildete Klemmenverhalten und begrenzen die Bandbreite. Wird der Kreis instabil, kann der Prüfling Schaden nehmen. Auch die Auslegung setzt Grenzen, denn um den Strom über die Koppelinduktivität einzuprägen, braucht der Emulator mehr Spannung als die nachgebildete Maschine. Hängt er am selben Zwischenkreis wie der Prüfling, fehlt ihm diese Reserve im oberen Drehzahlbereich. In all diesen Fällen kann ein Messergebnis vom Prüfstand stammen statt vom Prüfling. Schließlich endet jeder Emulator an seiner Endstufe: Eine reale Batterie liefert im Kurzschluss Ströme im Kiloampere-Bereich, ein Emulator nur, was seine Endstufe hergibt. Solche Fehlerfälle lassen sich deshalb nur bis zu dieser Grenze nachstellen.
Am Ende der Kette steht das vollständig aufgebaute System an der realen Strecke, also der physikalische Test [Garousi et al. 2018]. In der Praxis heißt diese Stufe Inbetriebnahme, Anlagenversuch oder Feldtest. Zum ersten Mal arbeitet hier das Seriensteuergerät mit seiner eigenen Software an der realen Strecke, und alles, was kein Modell abbildet, wirkt zusammen: die wahre Dynamik der Strecke, mechanisches Spiel, Fertigungstoleranzen, Temperatur, Feuchte und Verschleiß.
Lohnt sich. Die Frage stellt sich nicht, denn diese Stufe findet bei jedem Produkt statt. Offen ist nur, mit welcher Messmöglichkeit. Ein Beispiel: Ein Umrichter schaltet beim Kunden sporadisch ab. Ohne Aufzeichnung bestehen die Daten aus einem Fehlercode und dem Anruf des Kunden. Hält ein Ringpuffer die letzten Sekunden vor dem Abschalten fest, liegen Zwischenkreisspannung, Stromistwerte und Reglerzustand vor. Aus einer Vermutung wird ein Verlauf, den man im Labor oder im HiL nachstellen und nach der Korrektur erneut prüfen kann.
Kosten. Ein Teil fällt ohnehin an, denn jedes Produkt wird in Betrieb genommen und abgenommen. Gezielte Prüfungen in Klimakammer, EMV-Labor oder Dauerlauf kommen hinzu. Am meisten kostet aber die Zeit: Jeder Diagnosezyklus braucht den vollständigen Aufbau, Fehlerbilder lassen sich oft nicht gezielt auslösen, und das Gerät ist verbaut, sei es in der Anlage, in der Klimakammer oder beim Kunden. Außerdem kann an der realen Strecke Hardware Schaden nehmen.
Nutzen. Nur hier arbeitet das Seriensystem vollständig an der realen Strecke, im Labortest unter kontrollierten Bedingungen, im Feldtest unter denen, die beim Kunden tatsächlich auftreten. Die Messungen, die dabei entstehen, umfassen, was RCP noch nicht abbilden konnte: die Serienelektronik mit ihren Sensoren und Aktoren, Fertigungstoleranzen und den Betrieb über lange Zeit. Damit lässt sich das Streckenmodell gegen das vollständige System prüfen, und jede simulierte Stufe davor rechnet anschließend mit einem besseren Modell.
Chance. An der realen Strecke ist der Einblick in das System am geringsten, doch er lässt sich mit wenig Aufwand verbessern. Benötigt wird ein Zugang zu internen Größen, da man sonst als Black-Box testet [Mihalič et al. 2022]. Für Werte, die synchron zum Regelzyklus erfasst werden sollen, und für eine kontinuierliche Aufzeichnung ist eine Instrumentierung, die die Größen am Punkt ihrer Gültigkeit erfasst, in der Regel der geeignete Ansatz. Im Labor mit Debug-Probe kommen dafür RTT oder ITM infrage. Soll der Zugang über die Schnittstellen des Produkts laufen, damit er auch im ausgelieferten Gerät erhalten bleibt, bleiben XCP mit einer Mess- und Kalibriertoolchain oder ein in-band beschriebenes Verfahren wie es:prot.
Risiko. Am größten ist es, wenn SYSiL ohne Einblick in das System betrieben wird und dabei Prüfungen übernimmt, die in einer früheren Stufe billiger oder sicherer gewesen wären. Fehler zeigen sich dann spät, und weil die inneren Größen nicht sichtbar sind, dauert die Suche nach der Ursache entsprechend lange. Ein eingeplanter Messzugang wie XCP oder es:prot ändert das, wie die Chance zeigt.
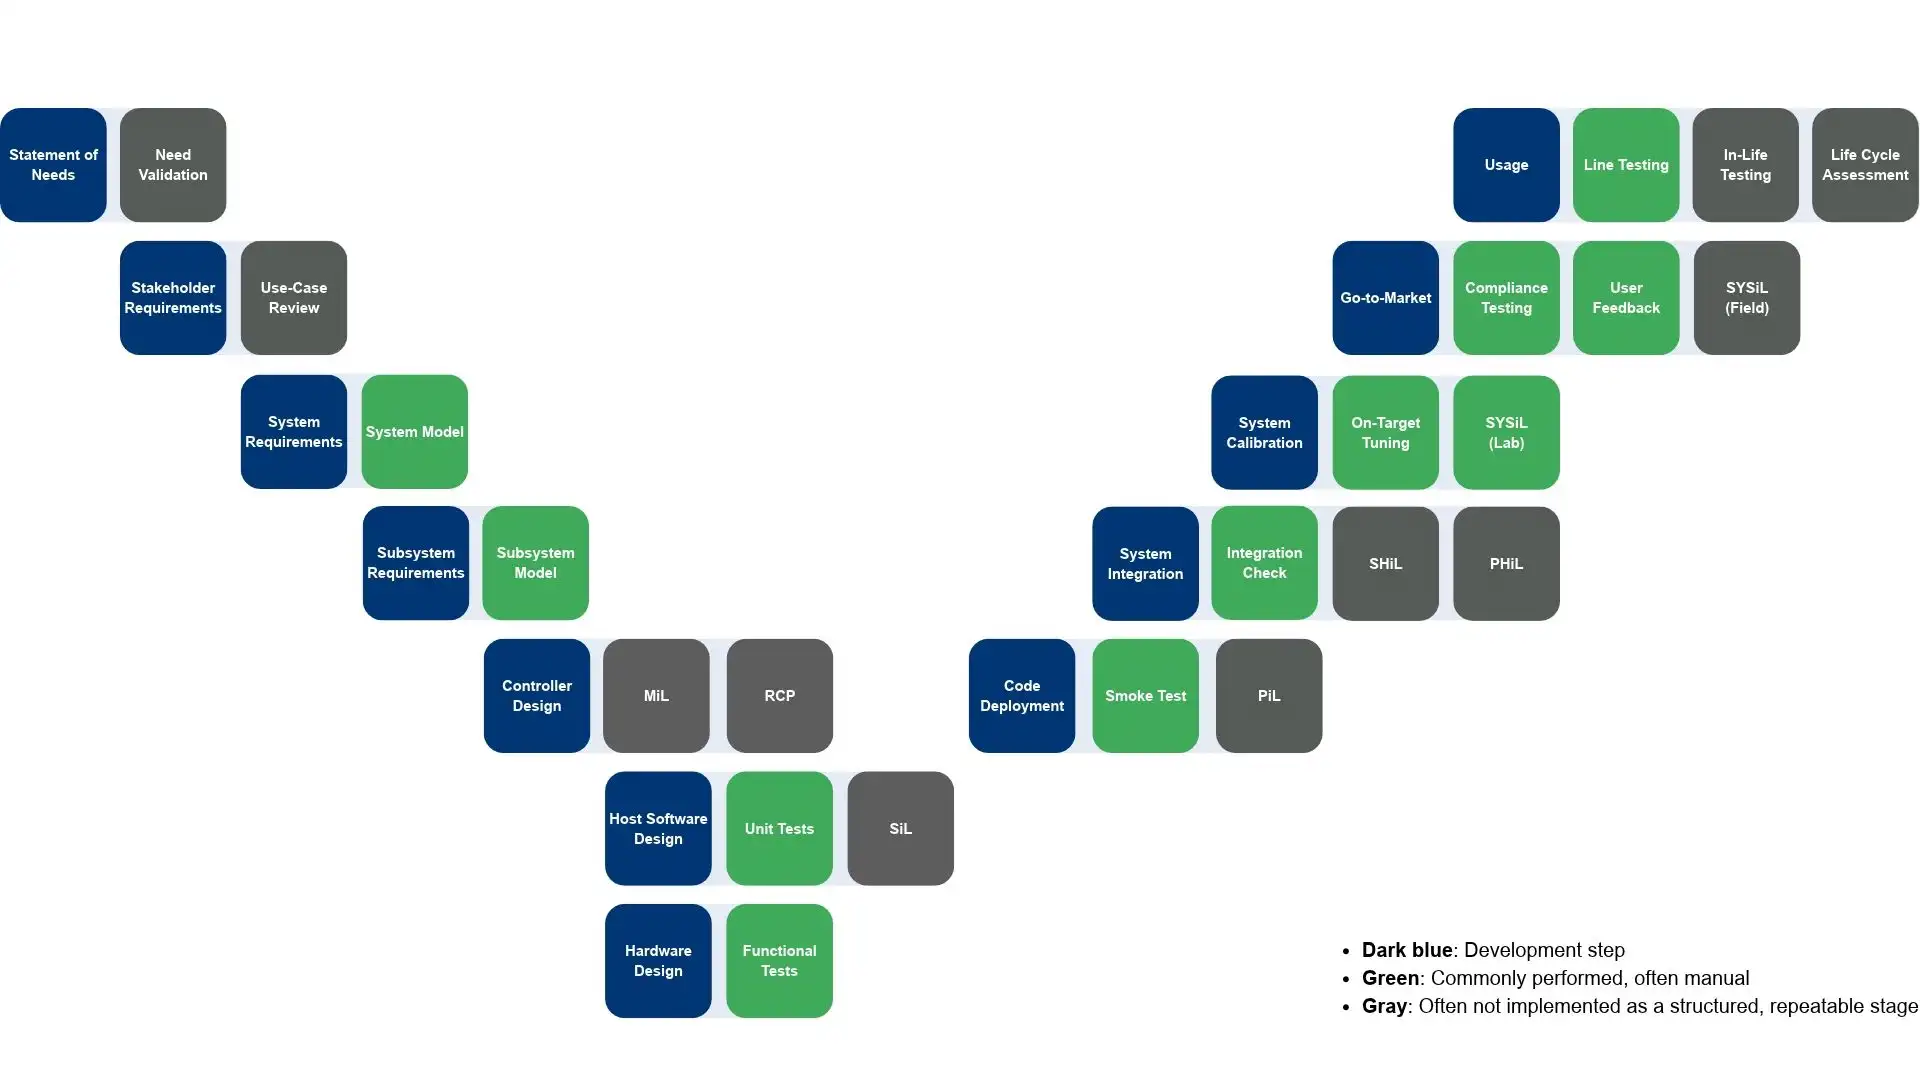
Abbildung 3: V-Modell mit Entwurfsstufen (dunkelblau), den üblichen Validierungsschritten (grün) und den oft bei der Embedded- Entwicklung übersprungenen modellbasierten In-the-Loop-Schritten (grau) (Quelle: eigene Abbildung).
Die vorgezogenen Prüfstufen lohnen sich vor allem, wenn Hardware und Software parallel entstehen (Abbildung 3). MiL bildet eine Ausnahme, weil dort der Regler ausgelegt und nicht nur geprüft wird. Es lohnt sich daher auch, wenn die Hardware schon steht. Für die übrigen Stufen bleiben dann Gefahr und Wiederholung als Gründe.
Was die Bedingungen gemeinsam haben
Neben dem Zeitpunkt, zu dem die Hardware verfügbar ist, und der Gefahr eines Versuchs tragen zwei Größen die Entscheidung. Die Wiederholung bestimmt, ob sich ein Aufbau trägt, und sie ist schwerer einzuschätzen, als es scheint: Ein Aufwand je Durchlauf multipliziert sich mit einer Zahl, die zu Projektbeginn niemand kennt. Die Beobachtbarkeit bestimmt, ob eine Stufe überhaupt etwas liefert. Lassen sich die Ergebnisse eines Prüfstands nicht bis zur Ursache verfolgen, weiß man zwar, dass etwas schiefgeht, aber nicht, warum. Die Komplexität des Systems, auf die sich das Bauchgefühl bei dieser Entscheidung meist beruft, kommt in beiden Größen nicht vor. Sie erhöht lediglich den Schaden, den ein unentdeckter Fehler anrichtet.
Zur Wiederholung gehört außerdem die Organisation. Was ein Durchlauf kostet, hängt auch davon ab, wie viele Abteilungen er durchläuft. Ist die Entwicklung verteilt, wartet jede Rückmeldung auf Prioritäten, andere Projekte und Abstimmungstermine, und die eigentliche Arbeit macht am Ende nur einen Bruchteil der Durchlaufzeit aus. Ein Werkzeug, mit dem sich Parameter ändern lassen, ohne neu zu kompilieren, zu flashen und zu übergeben, setzt deshalb an der ganzen Schleife an statt an einem einzelnen Schritt.
Eine Rechnung, die wir Ihnen nicht vorrechnen
Wir entwickeln selbst Werkzeuge für diesen Zweck und bauen Prüfstände. Gerade deshalb enthält dieser Beitrag keine Wirtschaftlichkeitsrechnung. Jede solche Rechnung, auch unsere, beruht auf Annahmen über Durchläufe, Fehlerhäufigkeiten und Stundensätze, und die schwanken zwischen Unternehmen so stark, dass sich jedes gewünschte Ergebnis herleiten lässt. Die Bedingungen oben lassen sich ohne uns beantworten. Auch die Zahl der Durchläufe, ab der sich ein Aufbau trägt, ergibt sich aus Größen, die Sie kennen: dem Aufwand für Aufbau und Pflege in Stunden, geteilt durch die Stunden, die jeder Durchlauf spart.
Der Befund
Wer die Bedingungen ehrlich durchgeht, kommt in der industriellen Embedded-Entwicklung oft zu einer unbequemen und zugleich entlastenden Antwort: Nein, kein HiL. Die Zahl der Durchläufe trägt ihn nicht.
Die Antwort endet dort aber nicht. Die Stufe, die ohnehin stattfindet, das reale System an der realen Strecke, läuft in denselben Unternehmen oft ohne Einblick in die internen Größen, mit einer Textausgabe als letztem Mittel. Die liefert keinen verlässlichen Zeitbezug und greift spürbar ins Timing ein. Die günstigste Investition ist deshalb oft nicht der Prüfstand, sondern der Einblick in das System, das ohnehin geprüft wird.
In der Fahrzeugentwicklung ist das gelöst: XCP mit Beschreibungsdatei und Mess- und Kalibriertoolchain ist dort Standard. Industrielle Zielsysteme haben diese Toolchain oft nicht, und viele Hersteller haben sich deshalb selbst geholfen: eine eigene Textausgabe, ein eigenes Protokoll über UART oder USB, ein eigenes Auswerteprogramm. Das ist kein Fehler. Ein eigenes Werkzeug passt genau auf das eigene Produkt, und es ist bezahlt. Ob es reicht, zeigen vier Fragen:
Dazu kommen zwei Fragen, die selten jemand stellt. Wer pflegt das Werkzeug, wenn der Kollege geht, der es gebaut hat? Und wer außer der Entwicklung kann es benutzen: die Inbetriebnahme, der Service, der Kunde? Eigene Werkzeuge dienen meist dem, der sie gebaut hat. Jede andere Abteilung schickt ihre Frage zurück in die Entwicklung, und die Schleife über die Organisationsgrenze bleibt so lang, wie sie war.
Wer alle Fragen mit Ja beantwortet, braucht nichts Neues. Wer an einer Stelle zögert, verliert dort Zeit, und zwar in jeder Schleife, also genau in der Größe, die über die Wirtschaftlichkeit entscheidet. Für Systeme ohne Mess- und Kalibriertoolchain haben wir einen eigenen Ansatz entwickelt, es:prot. Er erfasst deklarierte Größen am Punkt ihrer Gültigkeit als zusammengehörigen Satz, zeichnet ohne Lücken auf, erlaubt das Verstellen von Parametern im Betrieb und braucht keine zusätzliche Hardware. Die Beschreibung der Messgrößen wird beim Verbindungsaufbau in-band übertragen und kann daher nicht von der Firmware abweichen. Im Gegenzug muss jede Messgröße im Quellcode deklariert sein, und eine neue Größe braucht einen neuen Build. Dauerhaft gespeicherte Kalibrierdaten deckt es:prot bewusst nicht ab, dafür bleibt XCP die richtige Wahl. Wie wir zu diesem Ansatz gekommen sind und wie er sich gegen die anderen Werkzeugfamilien schlägt, zeigen wir auf dem ESE Kongress 2026, im Fachbeitrag in der Elektronik und im Whitepaper „The Appropriate Tool for Behavioral Insight“.
 Deutsch
 English